서·논술형 답안을 AI로 채점하겠다는 제안을 받으면 발주 기관이 가장 먼저 묻는 질문은 하나입니다. “사람 채점자와 얼마나 일치합니까?” 그리고 대개 하나의 숫자로 답이 돌아옵니다. 가중 카파 0.82, 상관계수 0.87 같은 식입니다. 이 숫자는 필요하지만 충분하지 않습니다. 채점 데이터를 다뤄 본 경험에서 반복해서 확인한 것은, 평균 일치도가 같아도 도입할 수 있는 문항과 도입하면 안 되는 문항이 갈린다는 사실입니다.
평균 일치도만 보면 놓치는 것
첫째, 사람 채점자끼리의 일치도입니다. AI와 사람의 일치도 0.82는 사람과 사람의 일치도가 0.90일 때와 0.75일 때 전혀 다른 의미를 갖습니다. 후자라면 AI는 이미 채점자 수준에 도달한 것이고, 전자라면 아직 멀었습니다. AI의 일치도는 언제나 채점자 간 일치도와 나란히 놓고 읽어야 합니다.
둘째, 점수대별 분포입니다. 중간 점수대 답안이 대부분인 문항에서는 AI가 중간 점수만 찍어도 평균 일치도가 높게 나옵니다. 정작 판별이 중요한 최상위와 최하위 답안에서 어긋난다면 그 모델은 쓸 수 없습니다.
셋째, 어긋나는 방향입니다. AI가 사람보다 일관되게 후하게 주는지, 박하게 주는지, 아니면 무작위로 흩어지는지에 따라 대응이 다릅니다. 일관된 편향은 보정할 수 있지만 무작위 오차는 보정할 수 없습니다.
저희가 쓰는 판정 절차
저희가 쓰는 판정 절차는 다음과 같습니다. 아래 수치는 절차를 설명하기 위해 만든 예시 데이터이며, 특정 기관의 검증 결과가 아닙니다. 순서가 중요합니다. 앞 단계를 통과하지 못한 문항은 뒤 단계로 가지 않습니다.
- 채점자 간 일치도 확보. 채점자 3인 이상의 점수가 있는 답안만 씁니다. 채점자 간 가중 일치도가 0.70 미만인 문항은 채점 기준 자체를 손봐야 하므로 AI 검증 대상에서 뺍니다.
- 준거 점수 산출. 채점자마다 엄격성이 다르므로 다국면 라쉬 모형으로 보정한 점수를 준거로 삼습니다. 단순 평균은 엄격한 채점자가 많이 배정된 답안에 불리합니다.
- 전체 일치도 계산. AI 점수와 준거 점수의 가중 카파를 구합니다. 여기까지가 보통 보고되는 숫자입니다.
- 점수대별 분해. 준거 점수를 상·중·하 세 구간으로 나눠 구간마다 일치도와 평균 편차를 따로 봅니다.
- 편향 방향 확인. AI 점수에서 준거 점수를 뺀 값의 분포를 문항별로 그립니다. 평균이 0에서 멀면 체계적 편향, 분산이 크면 무작위 오차입니다.
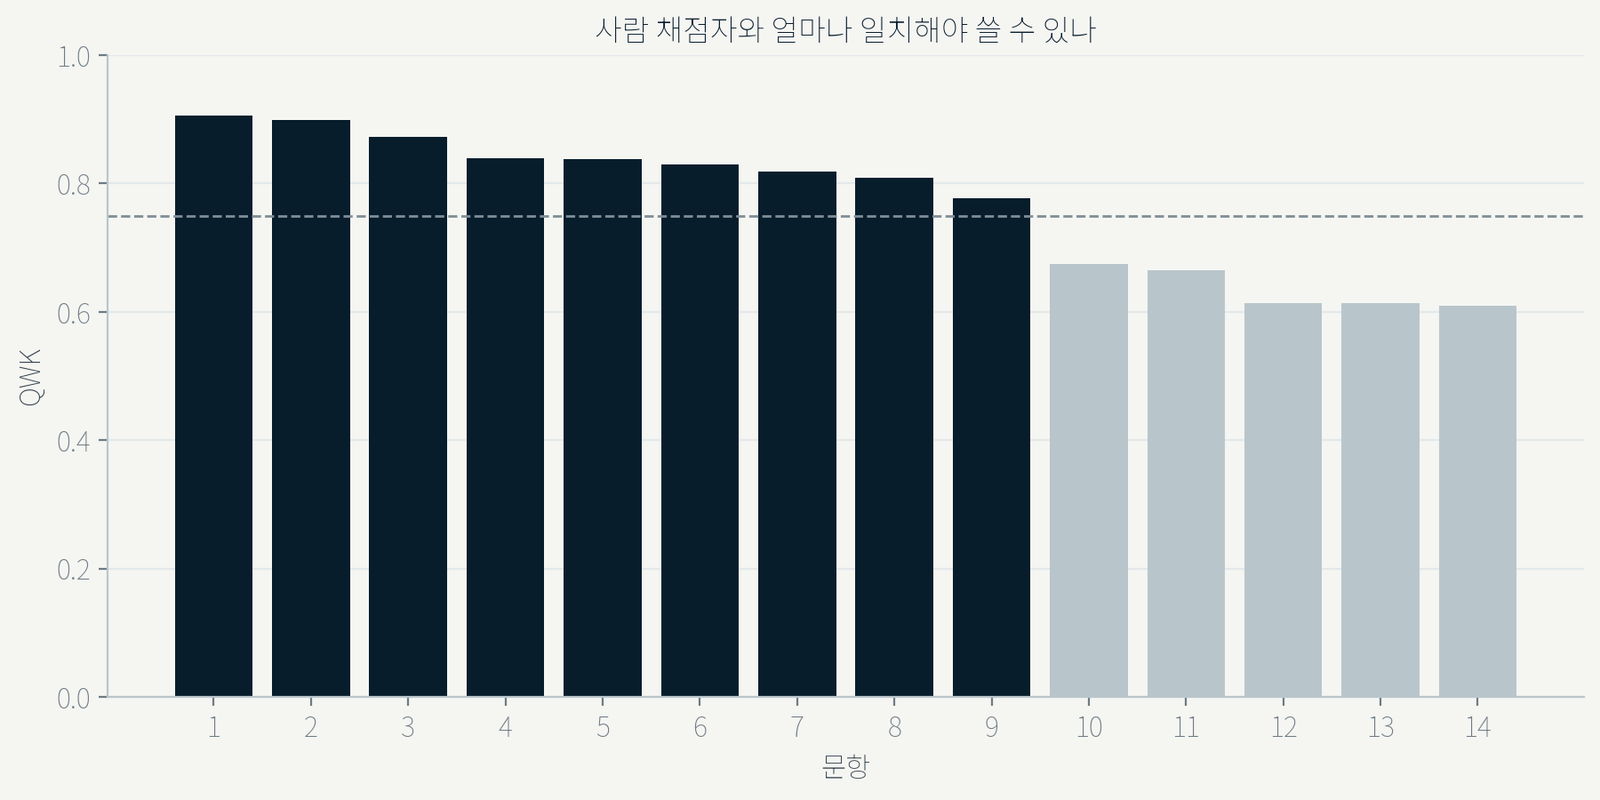
예시 결과: 14개 중 11개
전체 일치도 0.84는 채점자 간 일치도 0.86과 거의 같았습니다. 여기서 멈췄다면 모든 문항을 도입 가능으로 판정했을 것입니다. 점수대별로 나누자 그림이 달라졌습니다.
| 구간 | 답안 비율 | 일치도 | 평균 편차 | 해석 |
|---|---|---|---|---|
| 상위 (만점 근처) | 12% | 0.71 | −0.6점 | AI가 박하게 줌 |
| 중간 | 68% | 0.88 | +0.1점 | 안정적 |
| 하위 (0점 근처) | 20% | 0.79 | +0.4점 | AI가 후하게 줌 |
상위 구간에서 박하게 주는 경향은 세 문항에 집중돼 있었습니다. 셋 다 “근거를 두 가지 이상 제시하면 만점” 같은 개수 기준이 있는 문항이었고, AI는 근거를 하나로 묶어 세는 경우가 많았습니다. 이 세 문항은 도입 불가로 판정하고 채점 기준을 다시 쓰도록 권고했습니다. 나머지 11개 문항은 편차가 작고 방향이 일정해 보정 후 도입 가능으로 판정했습니다.
도입 가능한 문항과 아닌 문항을 가르는 것은 평균 일치도가 아니라, 어긋나는 답안이 어디에 몰려 있는가입니다.
발주할 때 요구할 것
자동채점을 검토하는 기관이라면 일치도 숫자 하나 대신 다음 네 가지를 함께 요구하시길 권합니다.
- 같은 답안에 대한 채점자 간 일치도
- 점수 구간별 일치도와 평균 편차
- 문항별 편향 방향과 크기
- 도입 불가로 판정한 문항과 그 이유
마지막 항목이 특히 중요합니다. 모든 문항이 도입 가능하다고만 보고하는 검증은 신뢰하기 어렵습니다. 어떤 문항에서 안 되는지를 말할 수 있어야, 되는 문항에 대한 판정도 믿을 수 있습니다.
한 가지 덧붙이면
이 절차는 AI 채점을 사람 채점의 대체로 보지 않습니다. 도입 가능 판정을 받은 문항도 상위 구간 답안은 사람이 한 번 더 보도록 설계했습니다. AI가 하는 일은 채점을 끝내는 것이 아니라, 사람이 봐야 할 답안을 줄여 주는 것입니다.