연구동향 분석은 학위·학술 연구에서 꾸준히 들어오는 일입니다. 특정 주제의 국내 논문을 모아 무엇이 많이 연구됐고 무엇이 비어 있는지 보여 달라는 요청입니다. 논문 160편 정도면 사람이 다 읽을 수도 있습니다. 그래도 세어서 보여 달라는 요청이 많습니다. 읽은 사람의 인상은 다른 사람이 확인할 수 없기 때문입니다.
수집 기준부터 적습니다
학술 데이터베이스 검색어와 검색 날짜, 포함 기준과 제외 기준을 먼저 적습니다. 학술지 논문만 넣을지 학위논문도 넣을지, 초록이 없는 논문은 어떻게 할지 정합니다. 같은 논문이 학위논문과 학술지 논문으로 두 번 잡히는 경우가 꼭 있습니다. 제목과 저자로 중복을 찾아 하나만 남깁니다.
이 기준이 바뀌면 뒤의 모든 숫자가 바뀝니다. 그래서 보고서의 첫 표는 연도별 편수와 자료원별 편수입니다.
용어 정리에 시간의 절반을 씁니다
초록은 같은 것을 다른 말로 씁니다. 한 주제에서 노인과 고령자와 어르신이 섞여 나오고, 영문 약어와 한글 표기가 섞입니다. 형태소 분석기가 이걸 알아서 묶어 주지 않습니다. 빈도 상위 300개 단어를 눈으로 훑으며 동의어 사전을 만들고, 분석에 의미 없는 단어를 불용어로 뺍니다. 연구, 결과, 대상자 같은 말은 모든 초록에 나오니 빼야 합니다.
사전을 만들고 나면 다시 돌리고, 또 상위 단어를 봅니다. 두세 번 반복합니다. 이 과정을 생략하면 상위 단어 목록이 연구 방법 용어로 채워집니다.
시기를 나눠야 동향이 됩니다
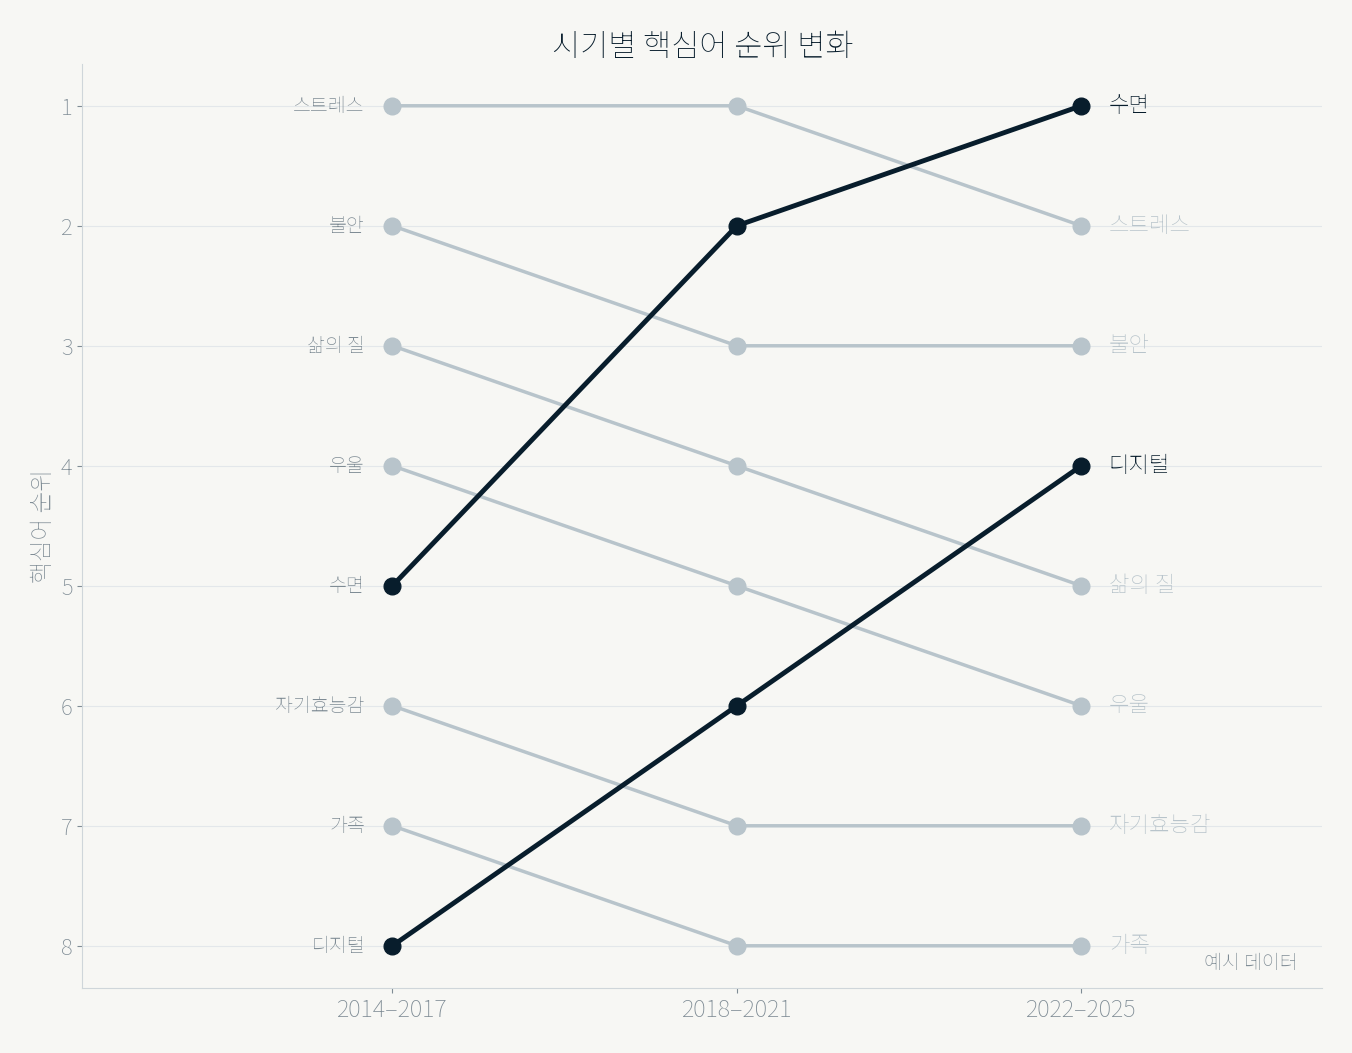
전체 기간을 합친 단어 빈도만으로는 동향을 말할 수 없습니다. 연도별 편수를 보고 비슷한 편수가 되도록 두세 시기로 나눕니다. 시기별로 TF-IDF 상위 단어를 뽑으면 그 시기에만 두드러진 단어가 나옵니다. 순위가 올라온 단어와 내려간 단어를 같은 그림에 두면 읽는 사람이 바로 이해합니다.
네트워크 그림에는 해석을 붙입니다
단어 동시출현 네트워크는 보고서에서 가장 눈에 띄는 그림이지만 가장 설명이 빠지는 그림이기도 합니다. 중심성이 높은 단어와 그 단어 주변의 군집에 이름을 붙이고, 각 군집을 대표하는 논문 두세 편을 적습니다. 군집에 이름을 붙이지 못하면 군집 수를 줄입니다. 설명할 수 없는 군집은 그림을 복잡하게 만들 뿐입니다.
토픽모델링은 꼭 필요할 때만
논문이 수백 편 수준이면 토픽모델링 결과가 불안정합니다. 토픽 수를 바꿀 때마다 주제가 다르게 묶이고, 같은 설정으로 다시 돌려도 달라집니다. 저희는 1,000편 아래에서는 빈도와 네트워크로 충분한 경우가 많다고 보고, 토픽모델링을 쓸 때는 여러 번 돌린 결과가 같은지 확인한 뒤에 씁니다.
숫자는 원문으로 확인합니다
숫자로 찾은 특징은 원문으로 확인합니다. 어떤 단어가 최근에 급증했다면 그 단어가 들어간 논문을 열어 실제로 그 주제를 다루는지 봅니다. 가끔 연구 대상이 아니라 제외 기준에 그 단어가 쓰인 경우가 있습니다. 보고서에는 숫자 옆에 확인한 논문을 적습니다.