연구 문제
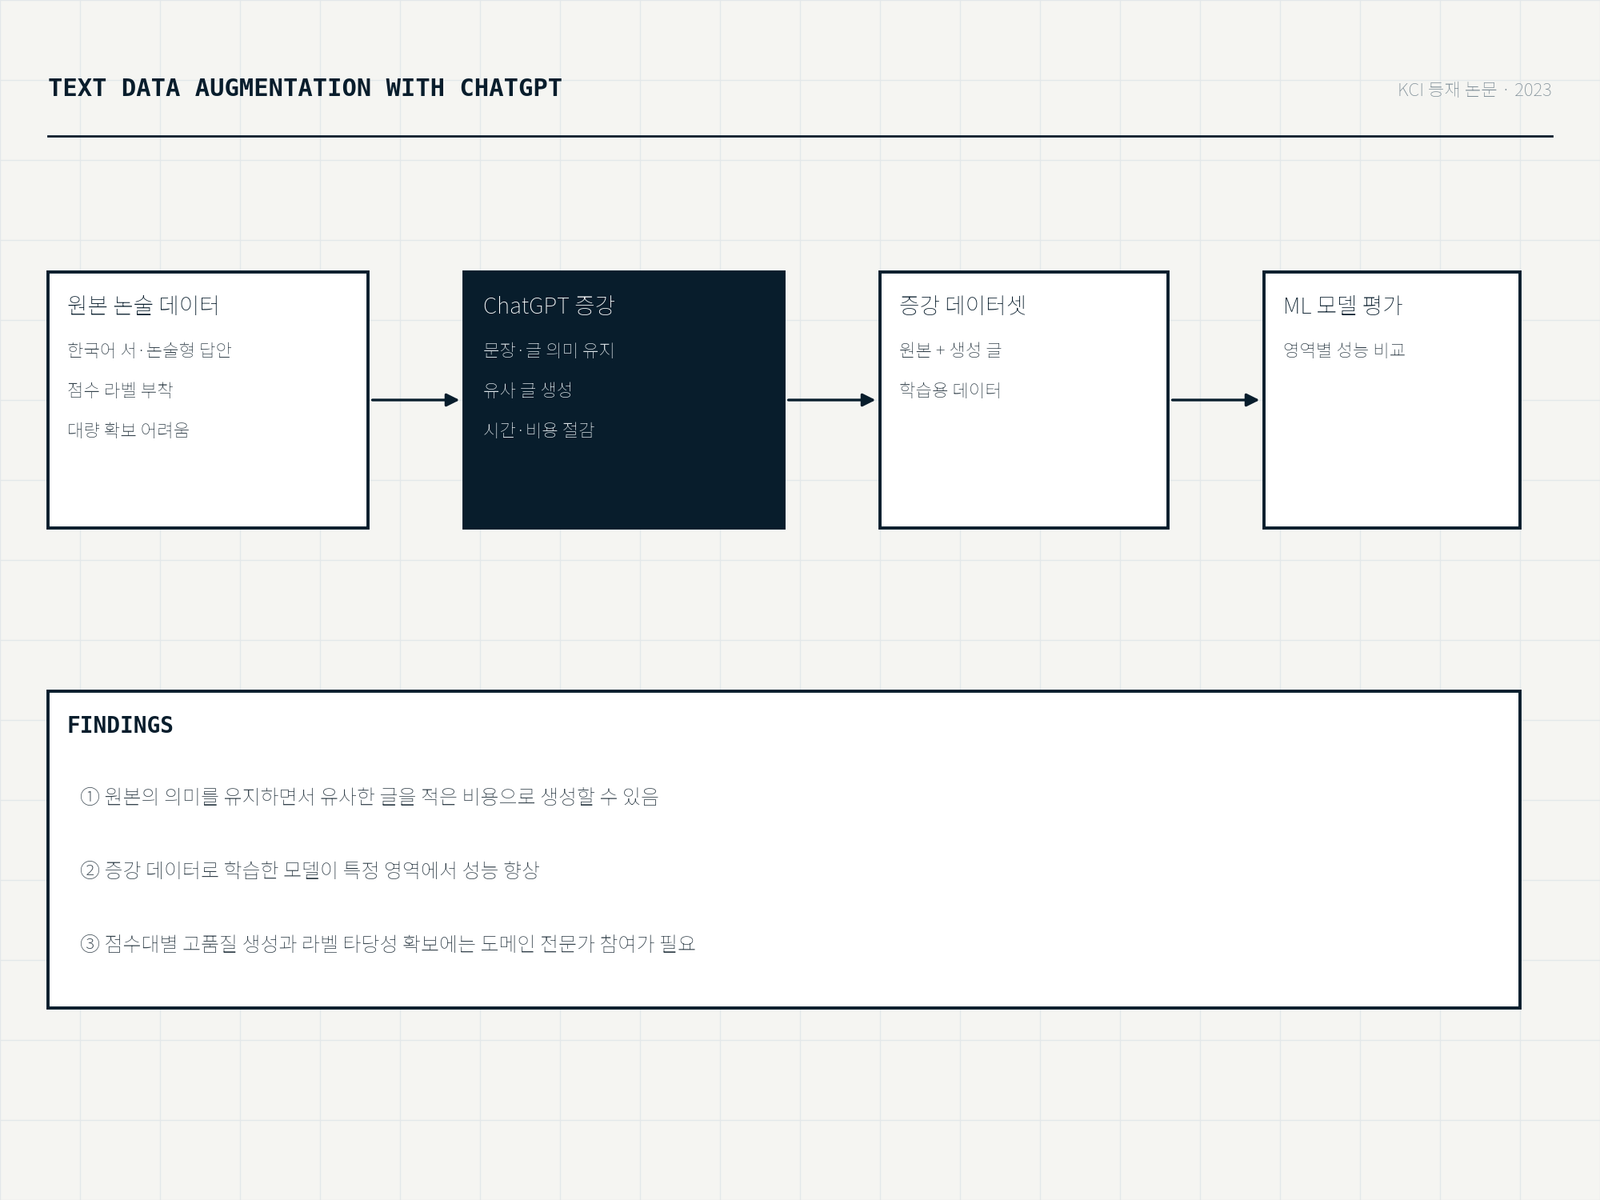
한국어 논술 데이터는 수집과 채점에 시간과 비용이 많이 들어 대량으로 모으기 어렵습니다. 생성한 글이 원본의 의미와 점수 수준을 유지하는지가 관건이었습니다.
방법
- 원본 답안의 문장·글 의미를 유지하도록 ChatGPT로 유사 글 생성
- 증강 데이터를 인공지능 학습용 데이터로 구성
- 원본만 쓴 모델과 증강 데이터를 더한 모델의 성능을 영역별로 비교
결과와 의의
시간·비용을 줄이면서 원본과 유사한 글을 생성할 수 있었고, 증강 데이터로 학습한 모델이 특정 영역에서 성능이 올랐습니다. 점수대별 고품질 생성과 라벨 타당성 확보에는 도메인 전문가 참여가 필요하다고 제안했습니다.
저자
김길재, 박강윤.
김길재 · 교육측정 · 서·논술형 자동채점과 문항 자동 생성 연구. 연구 전체 보기